
같은 실수를 반복하는 이유를 이해하려면 실수를 한 번의 사건이 아니라, 기록과 수정이 이어지는 구조로 봐야 합니다. 아래 내용에서 AI의 응답은 모델이 제시한 주장이지, 내부 구현을 직접 입증한 사실은 아닙니다.
세 AI에게 실제로 물어봤다
ChatGPT/OpenAI, Claude Code, AGY에 같은 주제를 물었고, 각 응답은 반복 실수의 원인을 조금씩 다르게 설명했습니다. 공통적으로는 이전 실패가 다음 행동에 자동으로 반영되지 않는 상황을 핵심 문제로 다뤘습니다.
ChatGPT/OpenAI (gpt-5.6-luna) — 수집 시각: 2026-10-07T22:33:46.079866+00:00
같은 실수를 반복하는 이유는 대체로 다음이 겹치기 때문입니다.Claude Code — 수집 시각: 2026-10-07T22:39:19.085398+00:00
같은 실수가 반복되는 구조적 이유는 세 가지입니다.AGY — 수집 시각: 2026-10-07T22:49:23.655199+00:00
실시간 학습의 부재: 언어 모델(LLM)은 매 요청마다 전달되는 대화 기록(컨텍스트)에 의존하여
텍스트를 확률적으로 생성합니다.
공통점과 차이
세 응답은 반복을 단순한 부주의보다 구조의 문제로 설명합니다. ChatGPT/OpenAI는 여러 원인의 결합을, Claude Code는 구조적 원인의 묶음을, AGY는 요청마다 전달되는 컨텍스트와 실시간 학습의 부재를 중심에 둡니다.
다만 이 문장만으로 특정 AI의 내부 학습 방식을 확정할 수는 없습니다. 실제 사용에서는 이전 대화가 새 요청에 포함됐는지, 실패 사례와 수정 규칙을 명시했는지, 같은 조건에서 다시 확인했는지를 구분해야 합니다.
| 응답원 | 실제 응답에서 언급한 관찰 |
|---|---|
| ChatGPT/OpenAI | 생성 패턴과 문맥 한계가 반복에 영향을 줄 수 있다는 관찰 |
| Claude Code | 세션 단절과 컨텍스트 압축이 이전 규칙의 연결을 약하게 만들 수 있다는 관찰 |
| AGY | 실시간 학습 부재와 컨텍스트·주의력 한계를 함께 언급한 관찰 |
이 표는 이 한 질문에 대한 각 모델 응답의 요약이며, 모델 내부 구현·정확도 순위·일반적 성능을 검증한 결과가 아닙니다.
구조 설명
사람이나 프로그램이 실수를 반복하는 흐름은 보통 행동 → 결과 → 기록 → 다음 행동 반영으로 이어집니다. 여기서 기록이나 반영 단계가 빠지면 실패 원인은 남지 않고, 다음 시도는 비슷한 조건에서 다시 시작됩니다.
AI에게도 비슷한 관찰 틀을 적용할 수 있습니다. 이전 요청의 기록이 현재 컨텍스트에 없거나, 무엇이 잘못됐는지와 바꿀 규칙이 분명하지 않으면 이전 실패를 참고할 입력이 부족해집니다. 이것은 내부 작동을 단정하는 설명이 아니라, 입력과 출력 사이에서 확인할 수 있는 사용 구조입니다.
대응 방법
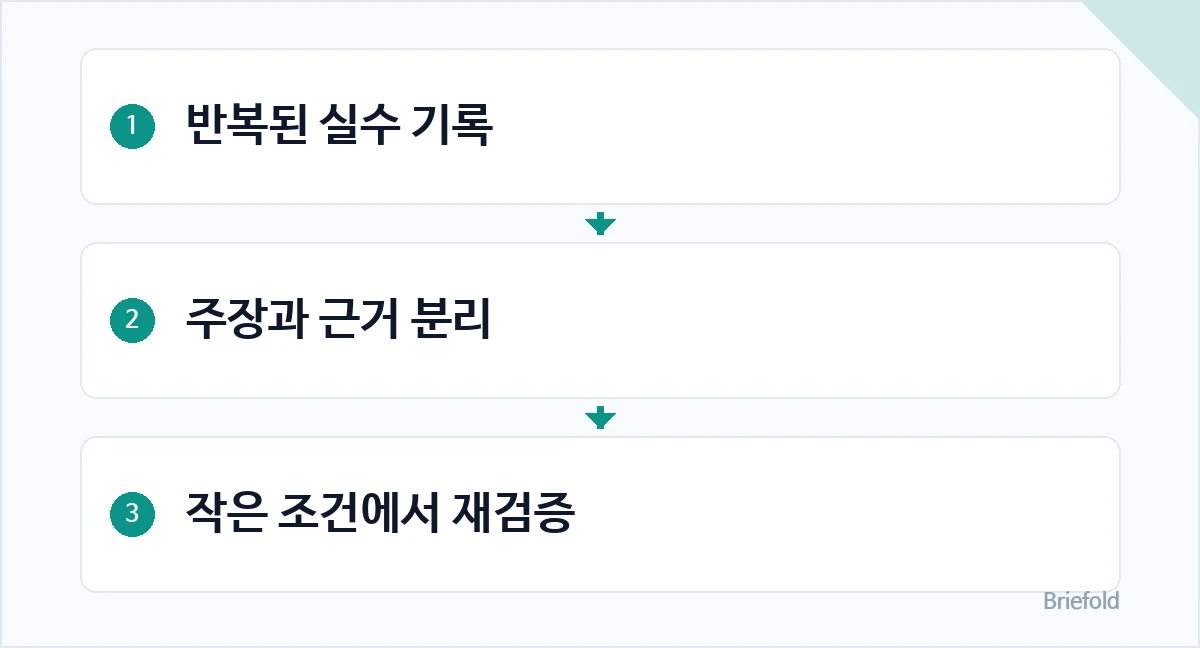
실수를 줄이려면 실패 기록을 다음 요청에 함께 확인하는 절차가 필요합니다. 아래 Python 예시는 오류 유형과 수정 규칙을 파일에 저장하는 설명용 예시이며, 이 글에서 실제 실행하거나 효과를 실험한 결과는 아닙니다.
import json
from pathlib import Path

log_file = Path("mistake_log.json")
record = {
    "mistake": "같은 조건에서 이전 오류를 다시 선택함",
    "cause": "이전 실패 기록이 요청에 포함되지 않음",
    "rule": "다음 실행 전에 최근 실패 기록을 먼저 확인"
}

logs = json.loads(log_file.read_text(encoding="utf-8")) if log_file.exists() else []
logs.append(record)
log_file.write_text(json.dumps(logs, ensure_ascii=False, indent=2), encoding="utf-8")
print("실패 기록을 저장했습니다.")
저장만 하고 다시 읽지 않으면 같은 문제가 생깁니다. 따라서 다음 요청이나 작업 전에 mistake_log.json을 열어 원인과 수정 규칙을 확인하고, 수정된 조건에서 결과가 달라졌는지 비교해야 합니다.
실제 사용에서 확인할 점
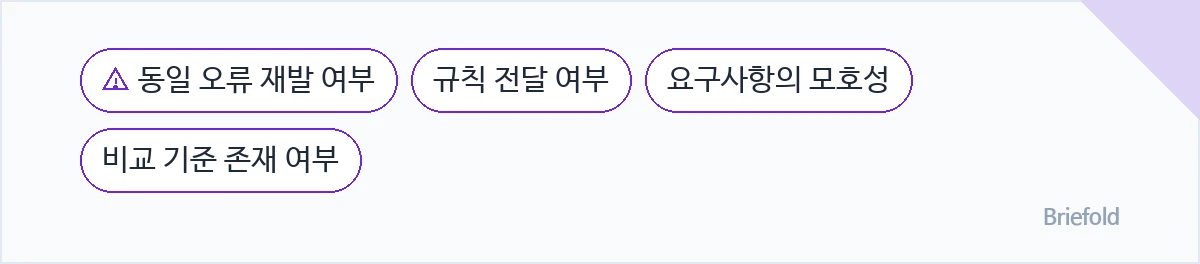
자주 묻는 질문은 “기록하면 반드시 같은 실수가 사라지나요?”입니다. 그렇지는 않습니다. 기록은 자동 해결 장치가 아니라 다음 행동에 참고할 정보를 제공하므로, 원인이 틀렸거나 수정 규칙을 실행하지 않으면 반복은 계속될 수 있습니다.
“대화 기록만 길게 넣으면 되나요?”라는 질문도 많습니다. 기록의 양보다 실패한 부분, 원인으로 추정한 조건, 다음에 바꿀 행동이 분명한지가 중요합니다. 같은 요청을 그대로 반복하지 말고 변경한 조건과 결과를 함께 적어야 차이를 확인할 수 있습니다.
세 AI의 원문 인용 확인
ChatGPT/OpenAI
같은 실수를 반복하는 이유는 대체로 다음이 겹치기 때문입니다.
- 생성 구조: AI는 정답을 보장하는 규칙 실행기라기보다, 주어진 문맥에서 다음 내용을 예측해 생성합니다. 한 번의 잘못된 전제나 패턴이 이어지면 비슷한 오류가 재생산될 수 있습니다.
- 문맥의 한계: 긴 대화에서는 중요한 지시가 덜 반영되거나, 서로 충돌하는 요구를 잘못 해석할 수 있습니다.
Claude Code
같은 실수가 반복되는 구조적 이유는 세 가지입니다.
- 세션 단절: 대화창마다 기본적으로 기억이 없습니다. 이전 세션에서 지적받은 내용은 그
세션에서만 유효하고, 명시적으로 memory 파일에 적어두지 않으면 다음 세션은 처음부터 시작합니다.- 컨텍스트 압축: 대화가 길어지면 과거 내용이 요약됩니다.
AGY
실시간 학습의 부재: 언어 모델(LLM)은 매 요청마다 전달되는 대화 기록(컨텍스트)에 의존하여
텍스트를 확률적으로 생성합니다. 사용자의 지적이나 교정을 실시간으로 모델 내부의 가중치에
학습하여 영구적인 기억으로 고정하는 구조가 아닙니다.
2. 컨텍스트 윈도우와 주의력(Attention)의 한계: 대화가 길어지면 과거에 교정받은 내용이
컨텍스트 제한에 의해 밀려나거나, 모델이 해당 정보에 할당하는 주의력 비중이 낮아져 잊어버린
것처럼 작동하게 됩니다.
정리
이 질문의 세 응답에서는 반복이 기록과 반영의 연결이 끊길 때 나타날 수 있다는 관찰이 공통으로 나왔습니다. 실제 원인은 작업·도구·입력 조건에 따라 다를 수 있으므로, 실패 원인과 수정 규칙을 남기고 다음 행동 전에 다시 확인하는 흐름을 만듭니다.