
로컬 LLM을 처음 올릴 때 대부분 모델 파일 크기부터 봅니다. 그런데 GPU로 로컬 LLM을 돌릴 때 실제로 발목을 잡는 것은 파일 크기가 아니라, 추론하는 동안 그래픽카드 메모리에 함께 올라가 있어야 하는 것들입니다.
왜 VRAM이 기준이 되는가
모델을 전부 GPU에 올리면 일반적으로 처리 속도에 유리하지만, 모든 런타임이 전체 가중치를 반드시 GPU에만 올려야 하는 것은 아닙니다. llama.cpp 같은 도구는 GPU에 올릴 레이어 수를 조절하고 나머지를 CPU에서 처리할 수 있습니다. 이 경우 VRAM 사용량을 줄이는 대신 속도가 낮아질 수 있습니다. llama.cpp 공식 옵션에서 --n-gpu-layers는 GPU 메모리에 둘 최대 레이어 수를 뜻합니다. GPU VRAM 로컬 LLM 조합에서는 “실행 가능한가”와 “원하는 속도로 얼마나 GPU에 올릴 수 있는가”를 구분해 보는 것이 중요합니다.
메모리에 올라가는 것은 세 가지입니다
첫째는 모델 가중치입니다. 파라미터 수에 비트 수를 곱해 8로 나눈 값은 대략적인 출발점일 뿐 실제 파일 크기와 같다고 볼 수 없습니다. 양자화 방식에 따른 부가 정보와 텐서별 정밀도 차이가 있기 때문입니다. 예를 들어 llama.cpp의 양자화 안내는 Llama 3.1 8B의 Q4_K_M 예시를 4.9 GB로 제시합니다. 모델과 양자화 방식이 다르면 크기도 달라집니다. 배포 파일 크기만 카드 용량과 비교하면 KV 캐시와 실행 여유를 놓칠 수 있습니다.
둘째는 KV 캐시입니다. 지금까지 읽은 토큰을 기억해 두는 공간이라 대화가 길어질수록 늘어납니다. 셋째는 런타임이 잡아먹는 여유 공간입니다. 이 둘을 빼놓으면 실행 도중 메모리 부족으로 멈춥니다.
같은 크기라도 구조에 따라 요구량이 갈립니다
KV 캐시는 파라미터 수가 아니라 어텐션 구조에서 나옵니다. 최근 모델은 층마다 방식이 다릅니다. Qwen 계열처럼 선형·전역 어텐션을 섞는 모델과 Gemma 계열처럼 로컬·전역 어텐션을 섞는 모델은 KV 캐시 증가 방식이 다를 수 있습니다. Gemma 4 31B 공식 설정은 60개 레이어에서 슬라이딩 어텐션 5개 뒤 전역 어텐션 1개가 반복되고, 슬라이딩 창은 1024토큰으로 설정돼 있습니다.
따라서 KV 캐시를 파라미터 수만으로 계산하면 오차가 커질 수 있습니다. 정확한 GiB 값을 제시하려면 KV 캐시 정밀도, 배치·동시 시퀀스 수, 컨텍스트 길이와 실행 엔진 조건까지 함께 고정해야 합니다. 이 글에서는 특정 모델의 고정 GiB 값을 보편값으로 단정하지 않고 실제 런타임 측정값을 함께 확인합니다.
전문가 혼합 모델은 총 파라미터로 봅니다
이름 끝에 A3B, A4B처럼 활성 파라미터 수가 표시된 전문가 혼합 모델은 토큰마다 일부 전문가만 계산에 참여합니다. 다만 활성 파라미터 수가 곧 GPU에 필요한 가중치 메모리라는 뜻은 아닙니다. 실행 엔진이 전체 가중치를 GPU에 둘 수도 있고 일부를 CPU·시스템 메모리에 남겨 둘 수도 있으므로, 총 가중치 크기와 실제 GPU 오프로딩 설정을 함께 확인해야 합니다.
선택 기준을 표로 확인합니다
| 상황 | 판단 기준 | 확인 방향 |
|---|---|---|
| 모델을 GPU에 최대한 올리고 싶음 | 가중치 크기 + KV 캐시 + 런타임 여유 | VRAM 실측과 컨텍스트 길이를 함께 확인 |
| VRAM이 부족하지만 실행이 목적 | CPU·GPU 레이어 배치 지원 여부 | 속도와 VRAM 사용량을 보며 GPU 레이어 수를 조정 |
| 긴 문맥·동시 요청이 많음 | KV 캐시 정밀도·컨텍스트·동시 시퀀스 수 | 단일 고정 GiB 수치보다 실제 런타임 측정 우선 |
| MoE 모델 선택 | 총 가중치와 활성 파라미터를 구분 | 활성 파라미터만 보고 GPU 메모리를 추정하지 않음 |
선택 기준은 모델 파일 크기 하나가 아니라 가중치가 어디에 배치되는지, KV 캐시 조건, 동시 처리 수와 목표 속도를 함께 보는 것입니다. 특정 모델의 정확한 VRAM 요구량은 실행 엔진과 설정에 따라 달라지므로 아래 도구의 값도 출발점으로만 사용하고 실제 실행 시 측정값을 대조하세요.
Gemma 4의 레이어 구성과 슬라이딩 창은 공식 모델 설정을 기준으로 설명합니다. Qwen 계열과 각 런타임의 실제 메모리 할당량은 양자화·오프로딩 설정에 따라 달라질 수 있으므로 실제 실행 환경에서 확인해야 합니다.
VRAM 선택 확인 순서
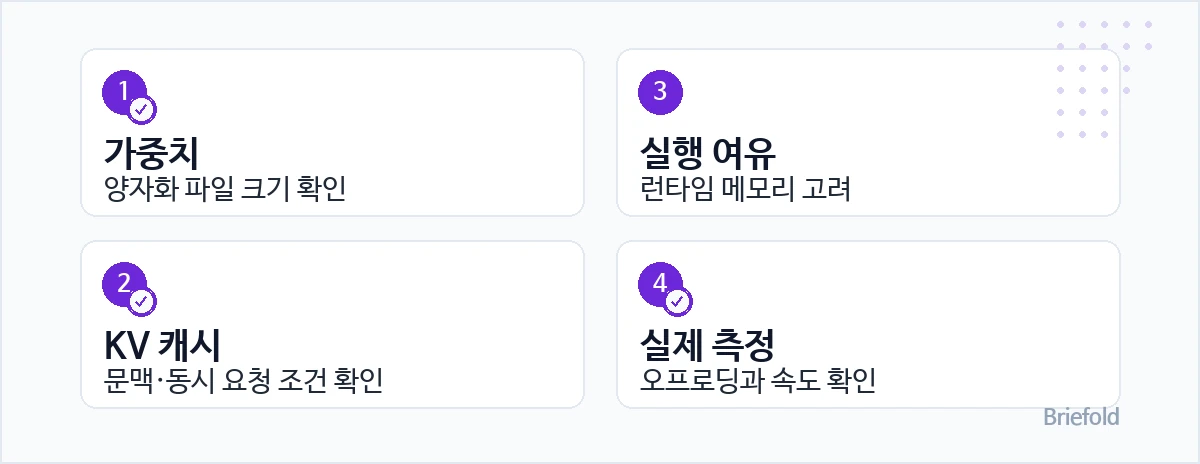
- 가중치: 양자화 파일 크기 확인
- KV 캐시: 문맥·동시 요청 조건 확인
- 실행 여유: 런타임 메모리 고려
- 실제 측정: 오프로딩과 속도 확인
내 그래픽카드로 확인해 보세요
아래 도구에서 쓰는 그래픽카드를 고르면 각 모델의 추정 사용량을 가중치와 KV 캐시로 나눠 보여줍니다.
VRAM 기준 로컬 LLM 추천 도구를 불러오는 중입니다.
표의 값은 8192토큰을 기준으로 한 추정치이며 실행 엔진, KV 캐시 정밀도, 배치·동시 처리 수와 CPU·GPU 레이어 배치 설정에 따라 실제 사용량이 달라질 수 있습니다. 경계에 걸친 조합은 추정값만 믿지 말고 해당 런타임의 실제 VRAM 사용량을 확인한 뒤 양자화나 오프로딩 범위를 조정하는 편이 안전합니다.