
목차
한국어 TTS 품질이 달라지는 이유
같은 한국어 TTS 엔진도 숫자·영문 전처리와 속도·억양 설정에 따라 영상에 쓰기 적합한 결과가 달라집니다.
같은 문장도 음성 모델에 따라 발음과 억양이 달라질 수 있습니다. 숫자, 영문, 약어, 고유명사, 괄호와 특수문자는 그대로 입력하면 읽는 방식이 어색해지기 쉽습니다. 한국어 띄어쓰기가 자연스럽지 않거나 문장이 너무 길어도 발음과 호흡이 불안정해집니다.
짧은 문장에서는 엔진 간 차이가 작아 보여도 긴 대본이나 반복 생성에서는 자연스러움과 안정성, 생성 시간과 비용의 차이가 커질 수 있습니다. 따라서 한두 문장만으로 품질을 판단하지 말고 자신의 대본 유형에 맞춰 비교해야 합니다.
자동화에서 먼저 처리할 텍스트
자동화 파이프라인에서 먼저 처리할 것은 TTS 엔진에 넣을 텍스트입니다. 숫자와 단위, 영문과 약어, 괄호와 특수문자를 읽기 쉬운 형태로 정리하고, 지나치게 긴 문장은 의미 단위로 나눠야 안정적인 합성을 기대할 수 있습니다.
문장부호는 일부 TTS 엔진에서 쉼과 억양에 영향을 줄 수 있으므로 모두 삭제하기보다 의도에 맞게 남겨야 합니다.
예를 들어 긴 문장을 그대로 합성하면 중간 쉼이 부족해 문장이 지나치게 빠르고 답답하게 이어질 수 있습니다. 반대로 문장을 지나치게 잘게 나누면 음성이 끊겨 들립니다. 생성 결과에서 발음이나 쉼이 어색한 문장만 찾아 재생성하는 방식이 전체 작업량을 줄이는 데 유리합니다.
TTS 엔진 선택 기준
엔진을 고르기 전에는 콘텐츠 유형, 영상 길이, 한국어 비중, 실시간 또는 배치 생성 여부를 정하고 품질·비용·생성 속도의 우선순위를 정해야 합니다. 실제 사용하는 TTS 엔진의 평가 항목은 발음 정확도, 자연스러움, 억양, 속도 조절 범위, 문장 사이 쉼, 긴 텍스트 처리 안정성, 생성 속도와 비용, 생성 실패 시 대응 방식입니다. 실제 선택 전에는 자신의 대본에서 숫자·영문·고유명사·긴 문장을 각각 시험해 보는 것이 좋습니다.
가장 흔한 실패는 숫자나 약어가 의도와 다르게 읽히는 경우입니다. 숫자 표기를 그대로 둔 상태에서 이런 현상이 나타나면 음성 자체를 바꾸기보다 전처리 결과를 먼저 확인해야 합니다. 변환 전후 텍스트를 비교하고, 문제가 있는 문장만 발음 표기나 풀어쓴 표현으로 수정한 뒤 다시 생성하면 원인을 구분할 수 있습니다.
속도는 빠를수록 좋은 것이 아니며, 억양은 설정값만으로 해결되지 않습니다. 문장 길이와 쉼표 위치를 함께 조정해야 쇼츠, 설명 영상, 긴 내레이션에 맞는 전달력을 만들 수 있습니다. 영상에 합성 음성과 자막을 함께 넣을 때는 음성의 길이와 자막 표시 시점도 확인해야 합니다. SRT와 FFmpeg로 자막 타이밍 맞추기에서 자막 시작·종료 시점을 점검하는 방법을 살펴볼 수 있습니다.
대본에서 음성까지 확인 순서
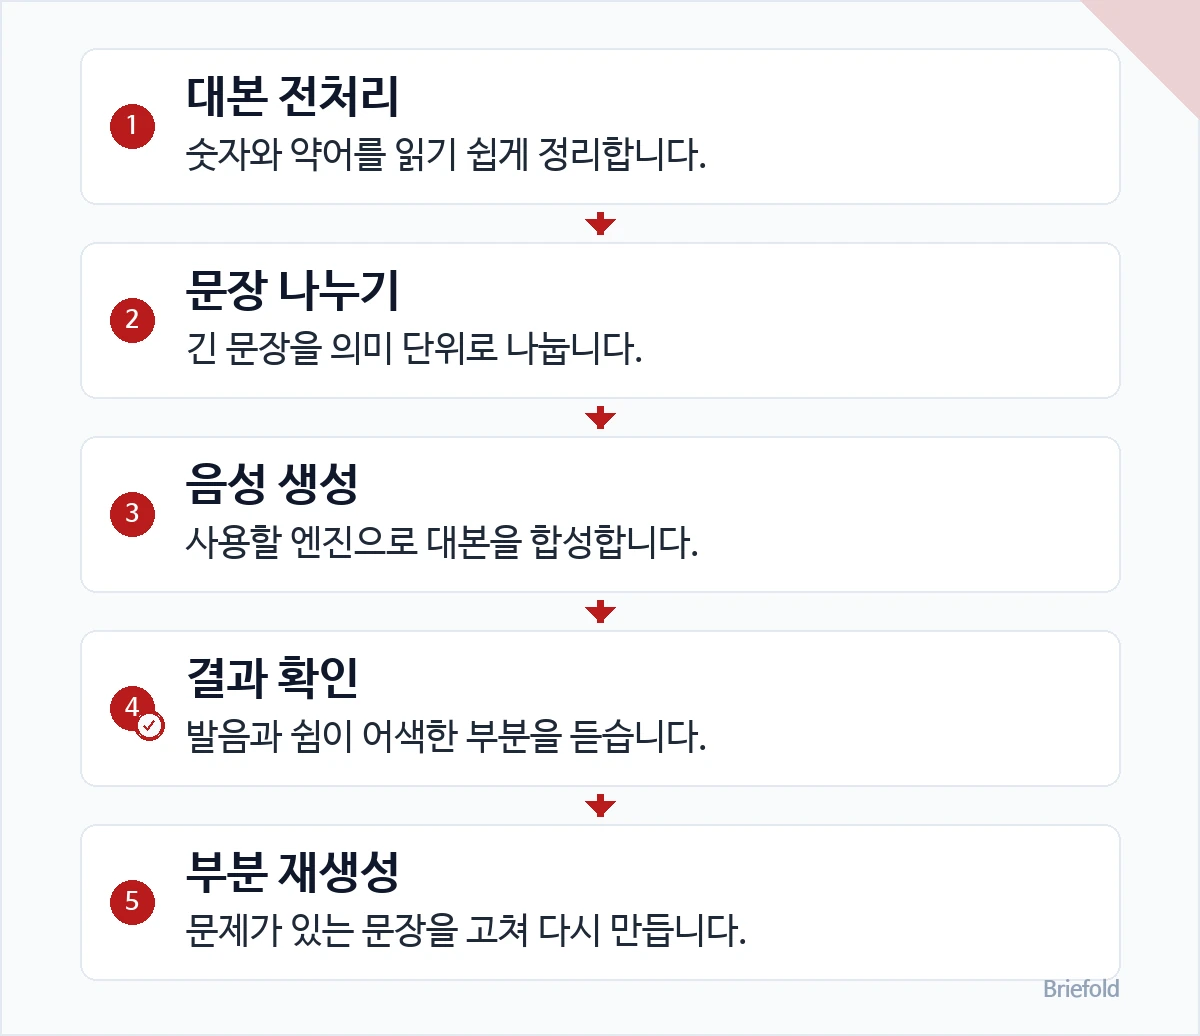
본문에서 설명한 한국어 음성 품질 확인 과정을 정리하면 다음과 같습니다.
- 대본 전처리: 숫자와 약어를 읽기 쉽게 정리합니다.
- 문장 나누기: 긴 문장을 의미 단위로 나눕니다.
- 음성 생성: 사용할 엔진으로 대본을 합성합니다.
- 결과 확인: 발음과 쉼이 어색한 부분을 듣습니다.
- 부분 재생성: 문제가 있는 문장을 고쳐 다시 만듭니다.
읽기 전 문자 정규화 예시
네트워크가 없는 격리 환경에서 Python으로 전각 영문과 숫자를 NFKC 정규화한 가상 예시입니다. 음성 합성이나 발음 품질을 실측한 결과는 아닙니다.
import unicodedata

original = "AI 2026년, 1200원"
normalized = unicodedata.normalize("NFKC", original)
print("원문:", original)
print("정규화:", normalized)
출력 예시:
원문: AI 2026년, 1200원
정규화: AI 2026년, 1200원
정규화 후 숫자와 영문이 일반 폭 문자로 바뀌었습니다. 정규화는 기호와 호환 문자도 바꿀 수 있으므로 원문을 따로 보존하고 결과를 검토하세요. 숫자를 어떻게 읽을지는 사용하는 음성 엔진과 문맥에 따라 별도로 확인해야 합니다.
한글 정규화와 문자열 비교
네트워크 없는 격리 Python에서 완성형 가와 이를 NFD로 분해한 문자열을 비교했습니다. 두 문자열 길이는 각각 1과 2였고 직접 비교는 False였지만, 분해된 문자열을 NFC로 다시 정규화하면 비교가 True였습니다. Python 정규화 문서에서 설명하는 서로 다른 표현의 예입니다.
이 차이는 겉보기에는 같은 대본이 중복 검출이나 검색에서 다르게 취급될 수 있다는 뜻입니다. 비교용 텍스트의 정규화 방식을 정하고 원문을 보존하세요. 이 실험은 음성 합성이나 발음 품질을 측정한 결과가 아닙니다.
결론
한국어 TTS 품질을 높이려면 엔진을 고르기 전에 대본을 읽기 쉬운 형태로 정리해야 합니다. 이후 콘텐츠 유형에 맞춰 엔진을 비교하고, 문제가 있는 문장만 다시 생성하는 순서로 접근하면 불필요한 시행착오를 줄일 수 있습니다.