
파일을 “다 읽었다”고 답해도 모든 문장을 같은 깊이로 검토했다는 뜻은 아닙니다. 긴 문서, 복잡한 표와 코드, 여러 지시가 섞인 입력에서는 중요한 내용이 빠질 수 있습니다. 아래 설명은 세 AI의 응답을 비교한 것이며, 내부 작동 원리가 입증됐다는 의미는 아닙니다.
세 AI에게 실제로 물어봤다
ChatGPT/OpenAI는 “파일을 모두 읽었다”는 말이 실제로 모든 내용을 완벽히 검토했다는 보장은 아닙니다. 일반적으로 모델은 입력된 텍스트를 토큰 단위로 처리하지만, 긴 파일은 문맥 한도·잘림·요약 과정의 손실 영향을 받을 수 있습니다. 내용이 반복되거나 표·코드·서식처럼 구조가 복잡하면 중요한 부분의 우선순위가 낮아질 수도 있고, 여러 지시가 섞이면 일부 요구를 놓칠 수 있습니다.
Claude Code는 “다 읽었다”는 보통 파일 끝까지 스캔했다는 뜻이지, 모든 줄에 동일한 주의를 쏟았다는 뜻은 아닙니다. 긴 파일일수록 앞부분과 뒷부분의 처리 비중이 달라질 수 있습니다 — 다만 이게 정확히 어떤 내부 메커니즘 때문인지는 모릅니다, 추측하지 않겠습니다.
- grep/검색으로 위치만 찾고 그 결과만 보고 결론을 내리는 경우가 있습니다 — 실제 전체 내용을 다시 읽지 않고 “확인됨”이라 판단하면, grep이 못 잡은 부분을 놓칩니다.
AGY는 AI가 문서를 다 읽었다고 하면서도 내용을 놓치는 현상은 구조적 한계에서 기인합니다.
- 주의력 분산(Lost in the middle): 언어 모델은 긴 텍스트의 처음과 끝은 잘 기억하지만, 중간에 위치한 정보는 어텐션(Attention) 가중치가 떨어져 쉽게 누락하는 경향이 있습니다.
공통점과 차이
세 응답은 “읽었다”와 “모든 내용을 정확히 확인했다”를 구분합니다. 다만 ChatGPT/OpenAI는 문맥 한도와 잘림, 서식 복잡성을 폭넓게 언급했고, Claude Code는 검색 결과만 보고 판단하는 작업 흐름을, AGY는 문서 중간부의 누락 가능성을 강조했습니다.
| 비교 항목 | ChatGPT/OpenAI | Claude Code | AGY |
|---|---|---|---|
| 핵심 원인 | 긴 입력과 복잡한 구조 | 검색 결과 의존 | 문서 중간부 누락 |
| 특히 놓치기 쉬운 내용 | 표·코드·반복문 | 검색되지 않은 부분 | 중간 위치 정보 |
| 설명의 성격 | 가능성 설명 | 작업 흐름 설명 | 구조적 경향 주장 |
구조 설명
파일을 읽는 행위는 책을 한 줄씩 동일한 집중도로 검토하는 일과 다릅니다. 긴 입력은 처리 가능한 문맥 범위, 요약 과정, 지시 우선순위의 영향을 받으며, 표·코드·중첩된 서식은 일반 문장보다 핵심 조건을 찾기 어렵게 만들 수 있습니다.
특히 검색은 위치를 찾는 도구이지 전체 검토의 증거가 아닙니다. 특정 단어가 검색되지 않았다고 관련 내용이 없다고 단정하면 표현이 다른 문장이나 이미지·표 안의 정보를 놓칠 수 있습니다.
대응 방법
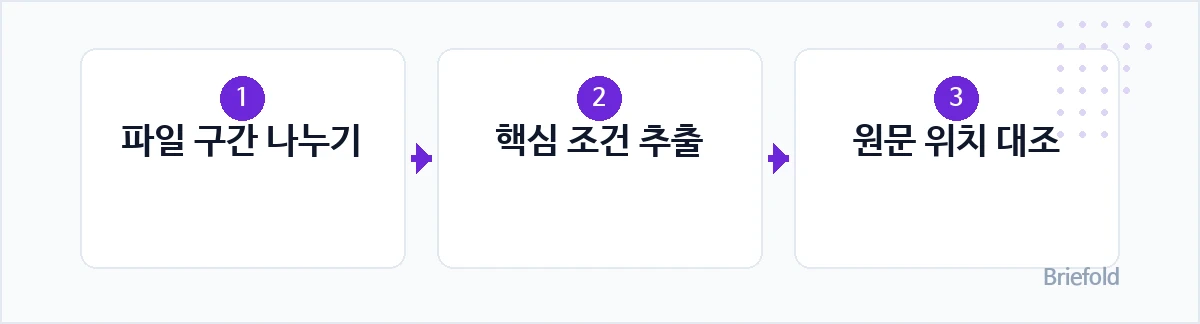
파일을 한 번에 맡기기보다 구간별 확인과 결과 검증을 나누는 편이 안전합니다. 예를 들어 아래 코드는 파일을 일정한 크기의 조각으로 나누고, 각 조각의 시작과 끝을 확인하는 기본 점검에 사용할 수 있습니다.
from pathlib import Path

text = Path("document.txt").read_text(encoding="utf-8")
chunk_size = 4000

chunks = [text[i:i + chunk_size] for i in range(0, len(text), chunk_size)]
print(f"전체 문자 수: {len(text)}")
print(f"검토 구간 수: {len(chunks)}")

for number, chunk in enumerate(chunks, start=1):
    print(f"구간 {number}: 시작={chunk[:40]!r}, 끝={chunk[-40:]!r}")
각 구간에 “핵심 조건, 예외, 숫자, TODO”를 따로 추출하게 한 뒤 원문과 대조하면 단순히 “읽었다”는 답보다 확인 범위를 분명히 만들 수 있습니다.
실제 사용에서 확인할 점
잘못되는 지점은 파일 끝까지 처리됐다는 답을 검토 완료로 오해하는 경우입니다. 긴 파일이나 여러 요구가 섞인 파일에서 이런 일이 생기면, 답변에는 검색된 일부 내용만 반영되거나 중간 조건이 빠지는 현상이 나타날 수 있습니다.
파일명과 구간 번호를 지정해 “3번 구간의 예외 조건을 인용하라”, “표의 마지막 행을 원문 그대로 확인하라”처럼 재질문하세요. 답변이 원문을 정확히 인용하지 못하면 해당 부분은 다시 검토해야 합니다.
자주 묻는 질문
파일을 여러 번 읽히면 완벽해지나요?
완벽해진다고 보장할 수 없습니다. 구간을 나누고 원문 인용, 조건 목록, 누락 여부 검사를 함께 요청해야 검증 수준이 높아집니다.
검색 결과만으로 파일을 확인해도 되나요?
검색은 후보 위치를 찾는 데 적합하지만 전체 확인을 대신하지는 못합니다. 검색어의 다른 표현과 주변 문맥을 함께 검토해야 합니다.
가장 먼저 확인할 내용은 무엇인가요?
문서의 중간 구간, 표와 코드, 예외 조건, 숫자와 날짜처럼 답변의 결론을 바꿀 수 있는 부분부터 원문 대조를 시작하는 것이 좋습니다.
세 AI의 원문 인용 확인
ChatGPT/OpenAI
“파일을 모두 읽었다”는 말이 실제로 모든 내용을 완벽히 검토했다는 보장은 아닙니다. 일반적으로 모델은 입력된 텍스트를 토큰 단위로 처리하지만, 긴 파일은 문맥 한도·잘림·요약 과정의 손실 영향을 받을 수 있습니다. 내용이 반복되거나 표·코드·서식처럼 구조가 복잡하면 중요한 부분의 우선순위가 낮아질 수도 있고, 여러 지시가 섞이면 일부 요구를 놓칠 수 있습니다.
Claude Code
“다 읽었다”는 보통 파일 끝까지 스캔했다는 뜻이지, 모든 줄에 동일한 주의를 쏟았다는 뜻이 아닙니다. 긴 파일일수록 앞부분과
뒷부분의 처리 비중이 달라질 수 있습니다 — 다만 이게 정확히 어떤 내부 메커니즘 때문인지는 모릅니다, 추측하지 않겠습니다.
2. grep/검색으로 위치만 찾고 그 결과만 보고 결론을 내리는 경우가 있습니다 — 실제 전체 내용을 다시 읽지 않고 “확인됨”이라
판단하면, grep이 못 잡은 부분을 놓칩니다.
AGY
AI가 문서를 다 읽었다고 하면서도 내용을 놓치는 현상은 구조적 한계에서 기인합니다.
- 주의력 분산(Lost in the middle): 언어 모델은 긴 텍스트의 처음과 끝은 잘 기억하지만, 중간에 위치한 정보는
어텐션(Attention) 가중치가 떨어져 쉽게 누락하는 경향이 있습니다.
정리
“다 읽었다”는 처리 완료 신호일 뿐, 완전한 검토 증명은 아닙니다. 구간 분할, 원문 인용, 조건별 대조를 함께 사용해야 누락을 발견할 수 있습니다.