
운영 컨테이너를 중단하지 않고 healthcheck 동작을 확인하려면 별도 테스트 컨테이너에서 상태 변화를 재현할 수 있습니다. 아래 명령은 운영 컨테이너가 아닌 예시 테스트 컨테이너를 기준으로 설명합니다. 명령의 <검증 컨테이너>는 자리표시자이므로 꺾쇠까지 포함해 실행하지 말고, 별도로 만든 테스트 컨테이너 이름으로 바꾸세요.
healthcheck 판정 조건
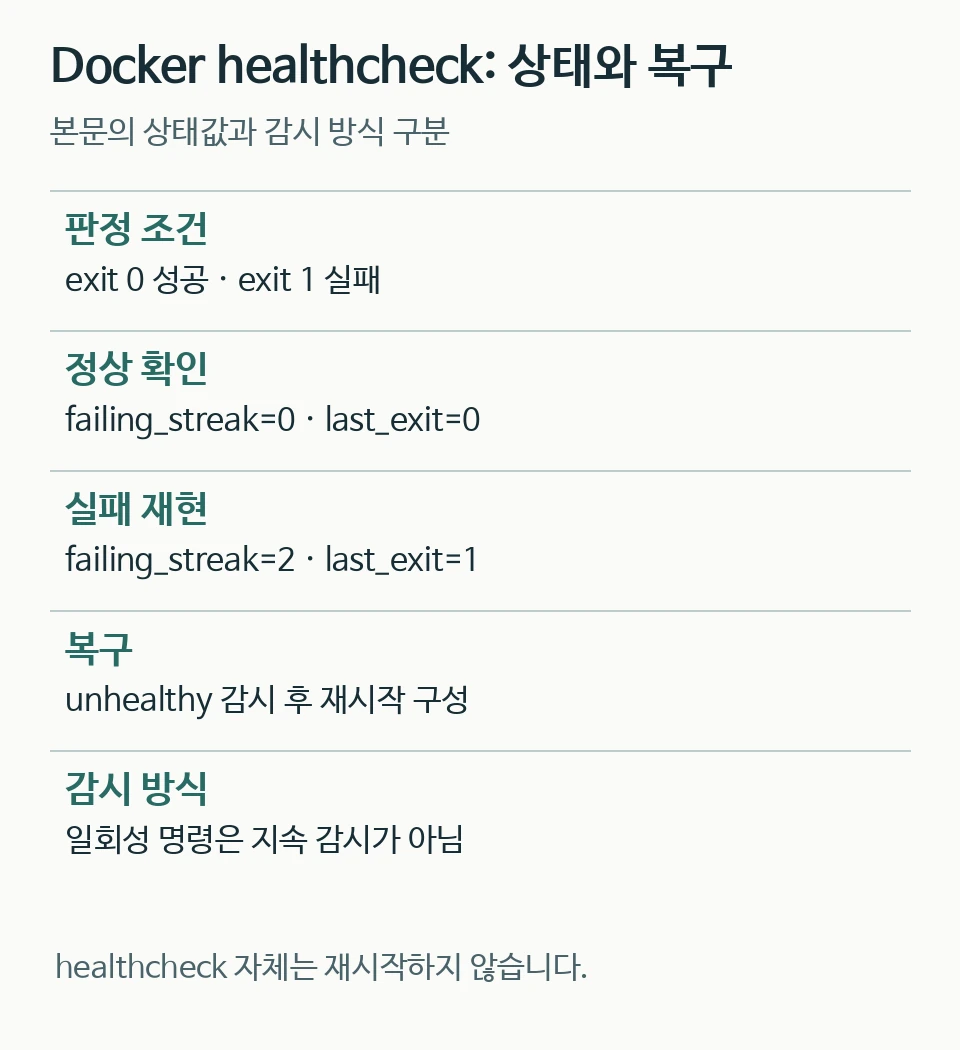
Docker healthcheck는 명령의 종료 코드로 상태를 판정합니다. 이 예시에서는 /tmp/ready가 있으면 exit 0, 없으면 exit 1이며 1초 간격·2회 연속 실패를 unhealthy 조건으로 사용합니다. 실제 운영에서는 컨테이너가 막 시작해 아직 준비되지 않은 구간의 실패가 곧바로 unhealthy로 잡히지 않도록 --start-period 옵션으로 초기 유예 시간을 따로 둘 수 있습니다. 공식 Dockerfile 레퍼런스에 따르면 이 유예 구간에서는 재시도 횟수와 무관하게 --start-interval 주기로 더 자주 검사합니다.
정상 상태를 명령으로 확인합니다
docker inspect --format '{{.State.Health.Status}}' <검증 컨테이너>
docker inspect <검증 컨테이너>  # State.Health.Log 마지막 ExitCode
예시 출력은 status=healthy failing_streak=0 last_exit=0이었습니다.
실패 조건을 재현합니다
docker exec <검증 컨테이너> sh -c 'unlink /tmp/ready'
docker inspect --format '{{.State.Health.Status}}' <검증 컨테이너>
파일 제거 뒤 status=unhealthy failing_streak=2 last_exit=1이 되었으며 실제 판정 근거입니다.
재시작 감시와 복구를 구분합니다
healthcheck 자체는 재시작하지 않습니다. 아래 예시는 상태를 확인한 외부 명령이 docker restart를 실행합니다. 이것은 Compose 재시작 정책과 별개입니다.
if [ "$(docker inspect --format '{{.State.Health.Status}}' <검증 컨테이너>)" = unhealthy ]; then docker restart <검증 컨테이너>; fi
테스트에서는 started_at_changed=true, 재시작 뒤 status=healthy failing_streak=0 last_exit=0을 확인했습니다. Compose의 restart 정책은 프로세스 종료를 다루므로 healthcheck와 별도입니다. Compose에서 의존 서비스의 준비 순서는 depends_on과 healthcheck 설명에서 따로 다룹니다.
일회성 명령과 지속 감시를 구분합니다
앞의 if 명령은 한 번 확인하고 끝나므로 이후에 unhealthy가 되어도 다시 실행되지 않습니다. 자동 재시작이라고 부르려면 외부 감시 프로세스가 상태를 계속 읽고, 대상 컨테이너 하나만 명시해 재시작해야 합니다.
container=${CONTAINER_NAME:?CONTAINER_NAME을 지정합니다}
while sleep 10; do
  status=$(docker inspect --format '{{.State.Health.Status}}' "$container")
  if [ "$status" = "unhealthy" ]; then
    docker restart "$container"
  fi
done
지속 감시 예시에서는 준비 파일을 제거해 unhealthy가 된 뒤 감시 조건이 docker restart를 한 번 실행했고, StartedAt 변경과 healthy 복귀를 확인했습니다. 이 루프는 동작 원리를 재현하는 최소 예시입니다. 실제 운영에서는 systemd 같은 감독자에 실행 제한과 로그를 두고, 재시작 횟수 상한·대기 시간·알림을 추가해야 재시작 폭주를 막을 수 있습니다.
Compose의 restart: unless-stopped는 컨테이너의 주 프로세스가 종료될 때 적용됩니다. healthcheck가 unhealthy를 표시하는 것만으로 주 프로세스가 종료되지는 않으므로, Compose restart 정책만으로 이 상태 전환을 자동 복구할 수 없습니다.