
Docker 컨테이너의 CPU와 메모리 사용량을 한눈에 확인하려면 cAdvisor, Prometheus, Grafana를 함께 구성하면 됩니다. Linux 서버에 Docker와 Docker Compose가 설치되어 있고 터미널 명령을 실행할 수 있는 환경을 전제로 합니다. 구성에 사용할 8080, 9090, 3000 포트가 다른 서비스에서 사용 중이면 충돌이 발생할 수 있으므로 테스트 환경에서 먼저 확인하세요.
목차
- 컨테이너 모니터링의 데이터 흐름
- cAdvisor와 Prometheus 구성
- Grafana 대시보드와 알림 설정
- 알림을 실제로 받기 (Alertmanager 설정)
- 문제 확인 방법
- 결론
컨테이너 모니터링의 데이터 흐름
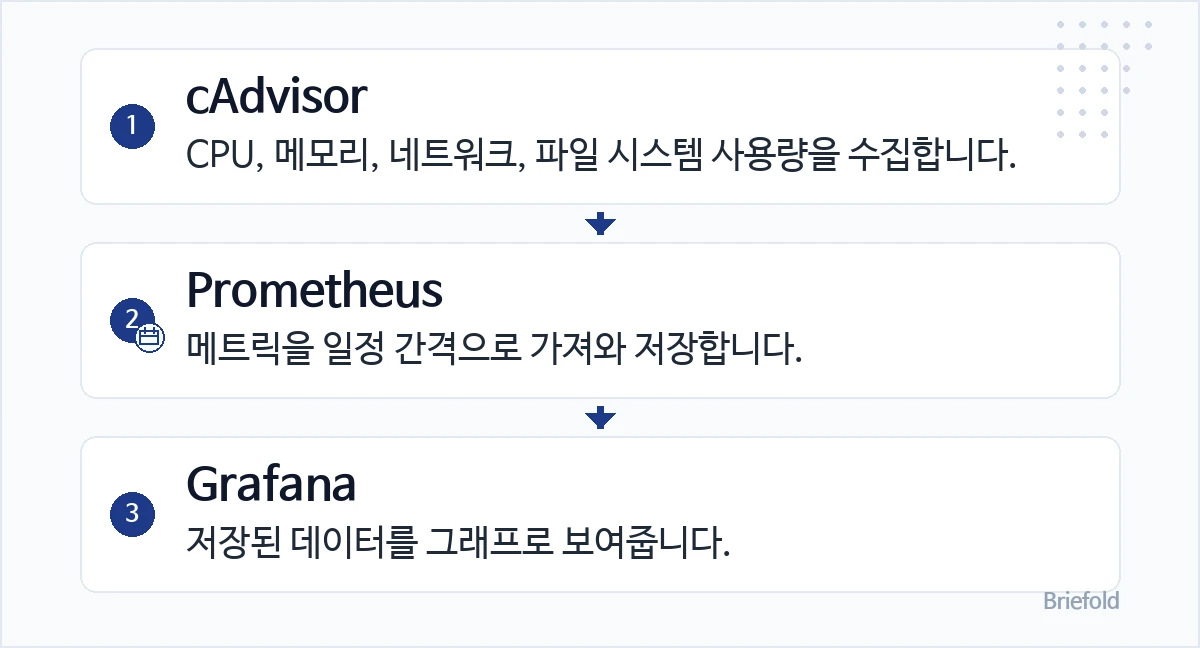
컨테이너 모니터링에서 세 서비스의 역할은 다음과 같습니다. 메트릭은 측정 가능한 운영 수치입니다.
- cAdvisor: CPU, 메모리, 네트워크, 파일 시스템 사용량을 수집합니다.
- Prometheus: 메트릭을 일정 간격으로 가져와 저장합니다.
- Grafana: 저장된 데이터를 그래프로 보여줍니다.
작업 폴더에 docker-compose.yml, prometheus.yml, rules.yml 파일을 준비합니다. 아래 구성은 세 서비스를 같은 Docker 네트워크에서 실행하므로 Prometheus가 cadvisor:8080이라는 서비스 이름으로 cAdvisor에 접근합니다.
세 서비스를 올린 뒤에는 Prometheus의 Targets에서 cAdvisor가 UP인지, Grafana가 데이터 소스를 읽는지, docker compose logs의 명령 출력에 권한·포트 오류가 없는지를 차례로 확인하세요. 포트 충돌 여부는 서버마다 달라집니다.
cAdvisor와 Prometheus 구성
먼저 Compose 파일을 작성합니다. cAdvisor가 호스트와 컨테이너 정보를 읽도록 일부 시스템 디렉터리를 읽기 전용으로 연결합니다. /var/run에는 Docker 데몬 소켓이 포함될 수 있습니다. 마운트에 :ro를 붙여도 소켓을 통한 API 요청 권한이 읽기 전용으로 제한되는 것은 아니므로, 소켓에 접근할 수 있는 컨테이너를 신뢰하고 접근 범위를 제한하세요. Docker의 데몬 접근 보안 안내도 데몬 접근 권한이 호스트 제어로 이어질 수 있음을 설명합니다.
services:
  cadvisor:
    image: gcr.io/cadvisor/cadvisor:v0.49.1
    ports:
      - "8080:8080"
    volumes:
      - /:/rootfs:ro
      - /var/run:/var/run:ro
      - /sys:/sys:ro
      - /var/lib/docker/:/var/lib/docker:ro

  prometheus:
    image: prom/prometheus:v2.53.0
    ports:
      - "9090:9090"
    volumes:
      - ./prometheus.yml:/etc/prometheus/prometheus.yml:ro
      - ./rules.yml:/etc/prometheus/rules.yml:ro

volumes:
  grafana_data:
prometheus.yml에서는 cAdvisor를 스크랩(메트릭을 주기적으로 수집하는 작업) 대상으로 지정합니다.
global:
  scrape_interval: 15s
rule_files:
  - /etc/prometheus/rules.yml
scrape_configs:
  - job_name: cadvisor
    static_configs:
      - targets: ["cadvisor:8080"]
docker compose up -d
Prometheus 화면의 Status와 Targets에서 cAdvisor 상태가 UP인지 확인합니다. DOWN이면 컨테이너 이름, 포트, Compose 네트워크 연결을 먼저 점검하세요.
Grafana 대시보드와 알림 설정
Grafana를 추가하려면 아래 항목을 Compose 파일의 services: 아래에서 cadvisor, prometheus와 같은 들여쓰기 수준에 넣고 다시 실행합니다. 파일 맨 아래의 최상위 volumes:는 이름 붙은 저장소를 선언하는 곳이므로 그 아래에 서비스를 넣지 않습니다. Docker Compose 공식 문서에서 서비스와 볼륨의 위치를 확인할 수 있습니다. Alertmanager 예시도 같은 services: 아래에 추가합니다.
  grafana:
    image: grafana/grafana:11.1.0
    ports:
      - "3000:3000"
    volumes:
      - grafana_data:/var/lib/grafana
    depends_on:
      - prometheus
브라우저에서 서버주소:3000으로 접속한 뒤 Grafana의 Connections → Data sources → Add data source → Prometheus 메뉴로 이동합니다. URL에는 http://prometheus:9090을 입력하고 저장합니다. 그런 다음 대시보드에서 새 대시보드를 만들고 패널을 추가한 뒤 쿼리 입력란에 container_memory_working_set_bytes나 rate(container_cpu_usage_seconds_total[5m])를 입력하면 컨테이너별 메모리와 CPU 변화를 표시할 수 있습니다.
알림 규칙은 rules.yml에 작성하며 Prometheus가 이 규칙을 평가합니다. 예를 들어 이 규칙은 각 컨테이너의 메모리 사용량이 약 1GB를 초과한 상태가 5분 이상 지속되는 경우 알림 대상으로 만듭니다.
groups:
  - name: container-alerts
    rules:
      - alert: ContainerMemoryHigh
        expr: container_memory_working_set_bytes > 1e9
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "컨테이너 메모리 사용량 확인"
Prometheus 설정이나 rule 파일을 변경한 뒤에는 docker compose restart prometheus로 Prometheus를 재시작해 변경 사항을 적용합니다. rules.yml에 정의한 규칙만으로는 알림이 실제로 발송되지 않습니다 — Alertmanager 연결까지 마쳐야 합니다.
알림을 실제로 받기 (Alertmanager 설정)
앞서 만든 알림 규칙은 Prometheus 안에서 경보 상태로만 표시될 뿐, 실제로 누군가에게 전달되지는 않습니다. 알림을 Slack이나 이메일로 받으려면 Alertmanager를 추가로 구성해야 합니다.
Compose 파일에 Alertmanager 서비스를 추가합니다.
  alertmanager:
    image: prom/alertmanager:v0.27.0
    ports:
      - "9093:9093"
    volumes:
      - ./alertmanager.yml:/etc/alertmanager/alertmanager.yml:ro
Prometheus가 Alertmanager로 경보를 전달하도록 prometheus.yml에 연결 정보를 추가합니다.
alerting:
  alertmanagers:
    - static_configs:
        - targets: ["alertmanager:9093"]
alertmanager.yml에서 수신자와 전달 경로를 정의합니다. 아래는 Slack Webhook으로 알림을 보내는 예시입니다.
route:
  receiver: slack-default
  group_wait: 30s
  group_interval: 5m
  repeat_interval: 4h

receivers:
  - name: slack-default
    slack_configs:
      - api_url: "https://hooks.slack.com/services/xxx/xxx/xxx"
        channel: "#alerts"
        send_resolved: true
api_url은 Slack 워크스페이스에서 발급받은 Incoming Webhook 주소로 바꿔야 합니다. 이 주소를 아는 사람은 알림을 보낼 수 있으므로 비밀번호처럼 취급하고 공개 저장소나 화면 공유에 노출하지 마세요. 노출됐다면 해당 Webhook을 폐기하고 새로 발급받아 설정을 교체합니다. 이메일로 받고 싶다면 slack_configs 대신 email_configs에 SMTP 서버 정보를 넣으면 됩니다.
위 Compose 예시는 서비스 포트를 호스트에 게시하므로 신뢰할 수 없는 네트워크에서 접근할 수 있는지 방화벽과 바인딩 설정을 먼저 확인하세요. 외부 공개가 필요 없는 관리 화면은 접근 가능한 범위를 제한하고 인증을 설정해야 합니다.
설정 파일을 저장한 뒤 Alertmanager와 Prometheus를 재시작해 반영합니다.
docker compose up -d alertmanager
docker compose restart prometheus
Alertmanager 화면(서버주소:9093)의 Status에서 설정이 정상적으로 로드됐는지 확인하고, Alerts 탭에서 실제로 들어오는 경보를 볼 수 있습니다. Grafana Alerting을 대신 쓰고 싶다면 Alertmanager 없이 Grafana의 Alerting → Contact points에서 Slack이나 이메일 채널을 등록하고 대시보드 패널에서 알림 규칙을 직접 만들면 됩니다 — 이 경우 rules.yml의 Prometheus 규칙과는 별개로 관리됩니다.
문제 확인 방법
cAdvisor가 실행 중인데 메트릭이 비어 있다면 호스트 볼륨 권한이나 Docker 데이터 경로가 환경과 맞지 않을 수 있습니다. docker compose logs cadvisor에서 권한 오류를 확인하고, docker inspect로 마운트 경로를 점검한 뒤 컨테이너를 재생성하세요.
2026년 10월 18일 11:01 KST에 Docker Engine 29.6.2에서 docker stats --no-stream으로 BF 백엔드 컨테이너 하나를 조회한 순간 CPU는 0.10%, 메모리는 132.7 MiB로 표시됐습니다. 이는 해당 시점의 단일 관측이며 cAdvisor·Prometheus·Grafana의 수집이나 알림이 작동했음을 검증한 결과는 아닙니다.
메모리 한도와 순간 사용량을 구분한 실험
2026년 10월 18일 Docker Engine 29.6.2의 네트워크 없는 별도 컨테이너에 메모리 한도를 64 MiB로 주고 cgroup v2의 memory.max와 memory.current를 읽었습니다. 각각 67108864, 13029376바이트가 출력됐습니다. 전자는 설정된 한도이고 후자는 그 순간의 사용량이므로 같은 숫자로 해석하면 안 됩니다. cat /sys/fs/cgroup/memory.max /sys/fs/cgroup/memory.current로 같은 항목을 살펴볼 수 있습니다.
이 값은 임시 컨테이너의 단일 시점이며 실제 서비스의 한도나 cAdvisor·Prometheus·Grafana의 수집·알림이 정상임을 뜻하지 않습니다.
결론
cAdvisor로 수집하고 Prometheus로 저장한 뒤 Grafana에서 시각화하면 Docker 컨테이너 상태를 지속적으로 확인할 수 있습니다. CPU·메모리 기준의 알림까지 추가하면 장애를 확인하는 시간이 짧아집니다.