
처음에는 단순히 유튜브 쇼츠 트렌드를 수집하려고 했습니다.
그런데 데이터를 저장할 DB가 필요했고, 자동화 워크플로가 필요했고, TTS가 필요했고, 컨테이너 관리가 필요했습니다. 하나를 해결하면 다음 문제가 보였습니다. 결국 하나의 AI 자동화 시스템으로 발전했습니다.
UGREEN DXP4800PLUS에서 운영한 AI 자동화는 각 컴포넌트의 역할과 연결 지점을 나눠 살펴볼 수 있습니다. 각 컴포넌트를 왜 선택했는지, 어떻게 연결했는지를 중심으로 설명합니다. 각 기술의 상세 내용은 개별 글 링크로 연결합니다.
전체 아키텍처
YouTube API
      ↓
Collector (수집기)
      ↓
PostgreSQL (데이터 저장)
      ↓
FastAPI (대시보드 + API)
      ↓
Edge-TTS (음성 생성)
      ↓
Video Generator (영상 합성)
      ↓
drafts 폴더 저장

n8n (워크플로 자동화)
      ↓
Telegram (알림)
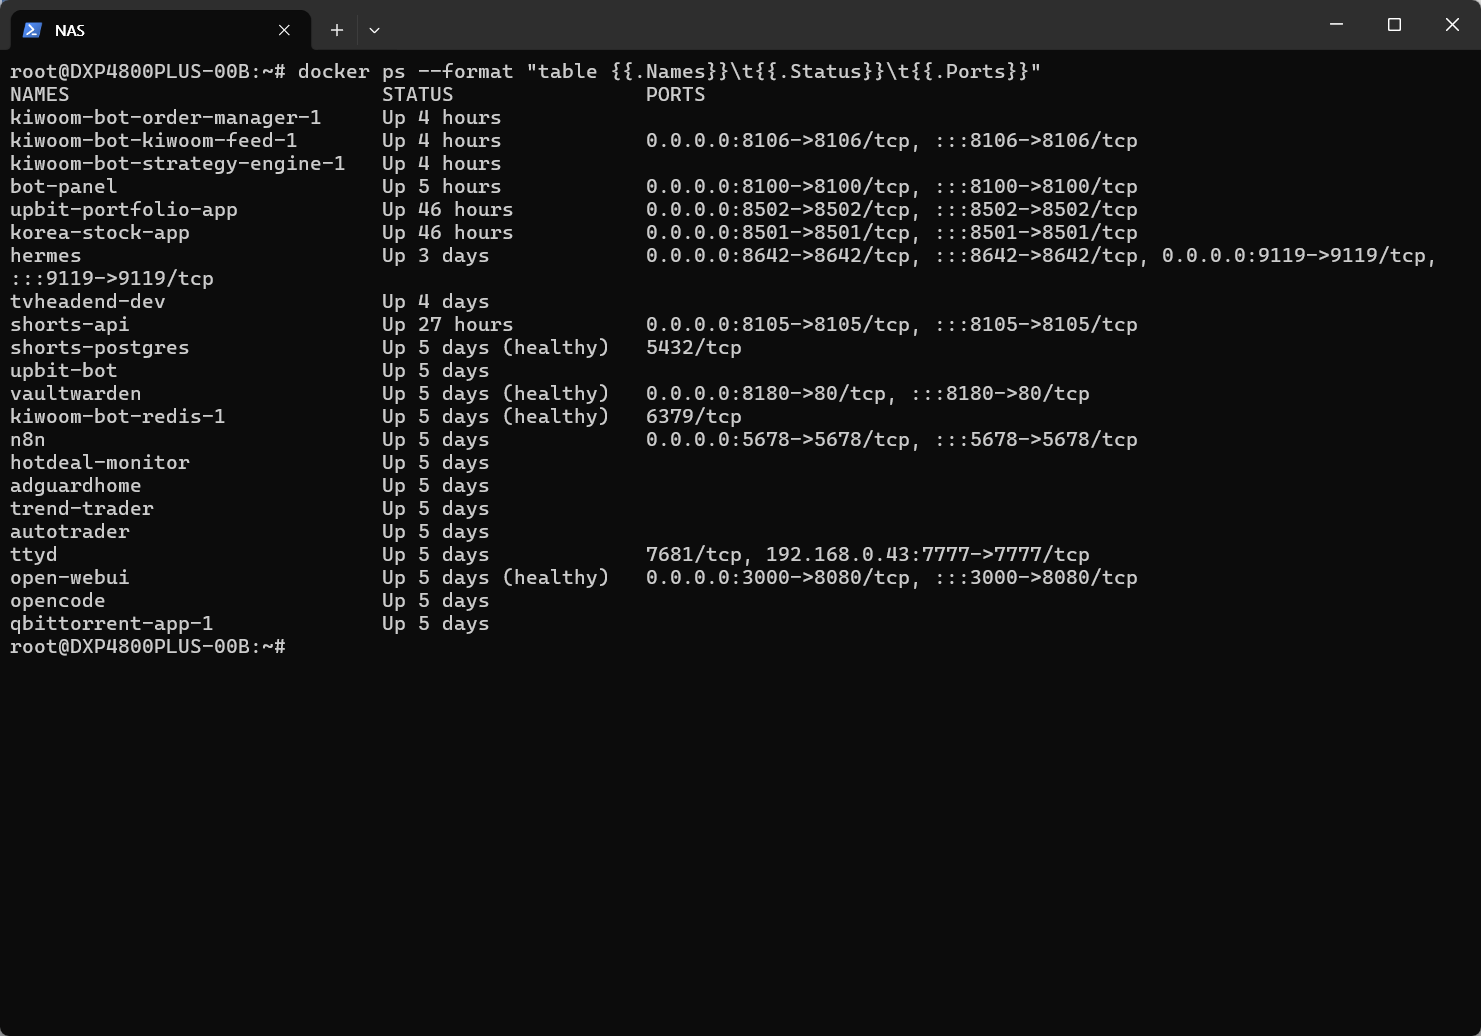
모든 서비스는 UGREEN DXP4800PLUS NAS에서 Docker 컨테이너로 운영됩니다.
왜 NAS를 선택했는가
클라우드 서버를 쓰면 월 고정 비용이 발생합니다. 여러 서비스를 동시에 운영하면 비용이 빠르게 늘어날 수 있습니다.
사례에서는 UGREEN DXP4800PLUS에서 20개 이상의 Docker 컨테이너를 운영했습니다. 실제 운영 비용은 전기료 외에도 사용하는 외부 서비스와 유지보수 범위에 따라 달라집니다.
Docker 계층: 모든 서비스의 기반
Docker가 없었다면 PostgreSQL, FastAPI, n8n을 각각 별도로 설치하고 관리해야 했습니다. Docker Compose로 각 서비스를 컨테이너 단위로 격리하고 하나의 스택으로 관리합니다.
Compose의 짧은 depends_on은 생성 순서를 정하지만 준비 완료까지 기다리지는 않습니다. Compose가 생성·재생성할 때는 healthcheck와 condition: service_healthy를 사용해 준비 상태를 기다릴 수 있습니다. NAS 재부팅 뒤 Docker 엔진의 컨테이너 재시작은 restart: unless-stopped 같은 재시작 정책의 별도 영역이며, 애플리케이션은 의존 서비스 연결 재시도도 둡니다.
관련 글:
- UGREEN DXP4800PLUS NAS에 Docker 설치하기
- UGREEN DXP4800PLUS NAS Docker Compose 설치 및 사용 가이드
- Docker Compose depends_on이 제대로 동작하지 않는 이유와 해결법
PostgreSQL 계층: 수집 데이터 영구 저장
처음에는 파일로 저장했습니다. 수집 데이터가 늘어나면서 중복 제거, 검색, 통계 계산이 필요해졌습니다. PostgreSQL로 전환했습니다.
중요한 것은 Docker 볼륨 설정입니다. 볼륨 없이 운영하다가 컨테이너 재생성 시 수백 개의 수집 데이터가 사라지는 경험을 했습니다. NAS 환경에서는 /volume2/docker/ 하위에 Bind Mount 방식으로 데이터를 영구 보존합니다.
사례 기록에는 수집 영상 약 700개와 스냅샷 4만 개 이상을 PostgreSQL에 저장한 것으로 나옵니다.
관련 글:
YouTube API 계층: 트렌드 데이터 수집
2026년 9월 16일 Google 공식 문서로 확인한 기준: YouTube Data API는 2026년 6월 1일부터 granular quota 체계를 사용합니다. search.list는 Search Queries 전용 버킷에서 호출당 1단위, 기본 100회/일로 관리되고, videos.list는 일반 quota 버킷에서 호출당 1단위를 사용합니다. 따라서 현재는 두 엔드포인트의 비용비를 예전 값으로 비교하기보다 “신규 검색에 별도 일일 한도가 있다”는 점을 기준으로 운영해야 합니다. search.list 공식 문서, videos.list 공식 문서, 변경 이력에서 확인할 수 있습니다.
현재 운영 원칙은 신규 발견과 기존 영상 갱신을 분리하는 것입니다. 신규 키워드 검색은 search.list의 Search Queries 일일 한도를 계산해 횟수를 제한하고, 이미 확보한 영상 ID의 조회수·좋아요·길이 같은 정보는 videos.list로 갱신합니다.
30분마다 검색하던 당시 운영 기록은 2026년 6월 이전 quota 체계에서 얻은 값입니다. 현재 quota 계산에는 그대로 적용하지 않습니다.
관련 글: YouTube API 쿼터 비용 이해하기
Edge-TTS 계층: 무료 한국어 음성 생성
수집된 트렌드 데이터로 쇼츠 영상을 자동 생성하는 파이프라인에서 TTS가 필요했습니다. ElevenLabs, OpenAI TTS는 비용이 발생합니다. Edge-TTS는 무료이면서 한국어 품질이 실용적인 수준입니다.
두 가지 문제를 겪었습니다. 영문 혼재 시 발음 오류(vs → 이상한 발음, API → 에이피아이)와 자막 싱크 불일치입니다. 전처리 규칙과 --write-subtitles 옵션으로 해결했습니다.
관련 글:
n8n 계층: 자동화의 관제 시스템
n8n은 스케줄링, 알림, 외부 서비스 연동을 담당합니다. 코드 없이 워크플로를 만들 수 있어서 반복 작업 자동화에 유용합니다.
사례의 워크플로:
매일 09:00
↓
기업마당 정책자금 공고 수집
↓
신규 공고 필터링
↓
Telegram 자동 알림
같은 구조로 GitHub 이슈 알림, 서버 상태 모니터링 등 다양한 자동화를 추가할 수 있습니다.
관련 글:
실제 운영 중인 서비스
현재 운영 중인 AI 자동화 스택:
├─ shorts-api (FastAPI 트렌드 대시보드)
├─ shorts-postgres (PostgreSQL)
├─ n8n (워크플로 자동화)
├─ hermes (AI 브리핑 에이전트)
└─ Edge-TTS 파이프라인 (영상 자동 생성)
이외에도 별도의 자동매매 시스템과 미디어 서버를 같은 NAS에서 운영 중입니다.
앞으로 추가 예정
모니터링 대시보드 (Grafana + Prometheus)
AI 에이전트 고도화
Video Factory 자동화 완성
Blogger 자동 발행 연동
관련 글 모음
Docker / NAS 인프라
- UGREEN DXP4800PLUS NAS에 Docker 설치하기
- UGREEN DXP4800PLUS NAS Docker Compose 설치 및 사용 가이드
- Docker Compose depends_on이 제대로 동작하지 않는 이유와 해결법
- Docker 재시작 후 PostgreSQL 데이터가 사라지는 이유와 영구 저장 방법
- FastAPI와 PostgreSQL 연동하기 (Docker 환경 실전 예제)
YouTube 자동화
- UGREEN DXP4800PLUS NAS로 유튜브 쇼츠 자동화 시스템 구축기
- YouTube Data API 쿼터 초과를 피하는 방법 (700개 쇼츠 수집 사례)
- YouTube API 검색이 느린 이유: search.list와 videos.list 차이점 완전 정리
- PostgreSQL로 YouTube 조회수 성장률 계산하기
- 유튜브 쇼츠를 Python으로 자동 생성하는 방법
개발 문제 해결
자동화 워크플로