
처음에는 단순히 API 몇 개 호출하면 끝날 줄 알았습니다.
UGREEN DXP4800PLUS NAS 위에서 유튜브 쇼츠 자동화 시스템을 구축하면서 YouTube Data API를 쓰기 시작했는데, 실제로 운영해보니 쿼터 관리가 더 큰 문제였습니다. YouTube Data API를 사용해 쇼츠 수집기나 트렌드 분석 시스템을 만들다 보면 쿼터(Quota) 부족 오류를 겪을 수 있습니다. 과거 쿼터 체계에서 하루 10,000유닛이면 사실상 무제한이라고 생각했는데, 글로벌 AI 키워드를 몇 개 추가하고 나서 하루도 지나지 않아 쿼터 부족 오류가 발생했습니다.
사례에서 약 700개 영상과 4만 개 이상의 스냅샷을 수집하며 부딪힌 쿼터 제한과 해결 방법을 정리합니다.
YouTube Data API 현재 quota 구조
2026년 9월 16일 기준: YouTube Data API는 2026년 6월 1일부터 granular quota 체계를 사용합니다. search.list는 Search Queries 전용 버킷에서 호출당 1단위, 기본 100회/일로 관리되고, videos.list는 일반 quota 버킷에서 호출당 1단위를 사용합니다. 따라서 현재는 두 엔드포인트의 비용비를 예전 값으로 비교하기보다 “신규 검색에 별도 일일 한도가 있다”는 점을 기준으로 운영해야 합니다. search.list 공식 문서, videos.list 공식 문서, 변경 이력을 기준으로 확인했습니다.
search.list: Search Queries 전용 버킷, 호출당 1단위, 기본 100회/일videos.list: 일반 quota 버킷, 호출당 1단위- 기타 일반 엔드포인트: 일반 quota 버킷에서 합산
따라서 현재 병목은 검색 호출의 “단가”보다 별도 Search Queries 일일 한도입니다. 반복 검색 횟수를 줄이고, 이미 아는 영상 ID는 videos.list로 갱신하는 방식이 맞습니다.
실제로 겪은 문제들
문제 1: 반복 검색으로 Search Queries 한도 소진
초기 운영에서는 같은 키워드를 짧은 주기로 반복 검색해 검색 관련 quota가 빠르게 소진됐습니다. 당시 기록은 2026년 6월 이전 quota 체계에서 얻은 값이므로 현재 비용 계산에 그대로 쓰면 안 됩니다.
현재는 키워드 4개를 30분마다 하루 48번 검색하면 search.list 호출이 192회가 되어 기본 Search Queries 100회/일 한도를 넘는다는 식으로 계산합니다. 이미 수집한 영상의 통계 갱신은 videos.list로 분리해 검색 횟수를 늘리지 않습니다.
videos.list?chart=mostPopular처럼 검색이 필요 없는 조회 경로도 목적에 맞으면 사용할 수 있지만, 키워드 검색과 같은 결과를 보장하는 대체재는 아닙니다.
문제 2: 수집은 되는데 AI/IT 콘텐츠가 없음
한국 급상승만 수집하니 약 500개 영상 중 AI_AUTOMATION 클러스터가 단 1개였습니다. 한국 유튜브 급상승에는 드라마, 연예, 뉴스가 압도적으로 많았습니다.
글로벌 키워드 검색을 추가했습니다. 단, search.list는 별도 Search Queries 기본 100회/일 한도가 있으므로 주기뿐 아니라 일일 호출 수 자체를 제한해야 합니다.
# 검색 대상 — search.list 호출 1회 = Search Queries 1회
AI_KEYWORDS = ["ChatGPT shorts", "Claude AI", "n8n automation"]
IT_KEYWORDS = ["tablet review shorts", "mini PC shorts", "NAS setup"]
SEARCH_QUERY_DAILY_LIMIT = 100
SEARCH_QUERY_RESERVE = 10  # 수동 점검·예외 호출용 여유
결과: AI_AUTOMATION 1개 → 61개, IT_DEVICE 0개 → 89개
문제 3: 스냅샷 수집과 성장률 계산
단순히 현재 조회수를 저장하는 것이 아니라 시간에 따른 변화량을 추적해야 했습니다. 처음에는 매번 전체 영상을 새로 수집했는데 이러면 쿼터가 부족했습니다.
기존 영상은 별도 배치로 갱신하는 방식으로 바꿨습니다.
from sqlalchemy import text

# AsyncSession 예시: 동기 Session이면 await 없이 session.execute()를 사용한다.
async def refresh_existing_snapshots(session, limit: int = 100):
    rows = (await session.execute(
        text("""SELECT video_id FROM videos
                WHERE last_updated < NOW() - INTERVAL '25 minutes'
                ORDER BY last_updated ASC LIMIT :limit"""),
        {"limit": limit},
    )).mappings().all()
    video_ids = [row["video_id"] for row in rows if row["video_id"]]
    for batch in chunks(video_ids, 50):
        stats = await videos_list(batch)
        # chunks와 videos_list는 이 글의 구조 설명용 별도 구현이다.
50개를 한 번에 조회하면 1유닛. 100개를 조회해도 2유닛입니다.
API 쿼터를 아끼기 위해 수집 주기를 분리한 이유
가장 효과적이었던 방법은 수집 주기를 두 단계로 나누는 것이었습니다.
글로벌 키워드 수집은 search.list의 Search Queries 일일 한도를 사용하고, 기존 영상의 스냅샷 갱신은 videos.list의 일반 quota 버킷을 사용합니다. 검색 횟수 한도와 갱신 배치를 각각 관리해 불필요한 반복 검색을 줄입니다.
from datetime import datetime
from pathlib import Path
from zoneinfo import ZoneInfo
import json
import os

# IANA 시간대 데이터가 없는 최소 이미지에서는 tzdata를 준비한다.
STATE = Path("/data/search-query-quota.json")
SEARCH_QUERY_DAILY_LIMIT = 100
SEARCH_QUERY_RESERVE = 10

def reserve_search_calls(count: int = 1) -> bool:
    today = datetime.now(ZoneInfo("America/Los_Angeles")).date().isoformat()
    state = {"date": today, "used": 0}
    if STATE.exists():
        state = json.loads(STATE.read_text())
    if state.get("date") != today:
        state = {"date": today, "used": 0}
    ceiling = SEARCH_QUERY_DAILY_LIMIT - SEARCH_QUERY_RESERVE
    if state["used"] + count > ceiling:
        return False
    state["used"] += count
    STATE.parent.mkdir(parents=True, exist_ok=True)
    tmp = STATE.with_suffix(".tmp")
    tmp.write_text(json.dumps(state))
    os.replace(tmp, STATE)
    return True

async def budgeted_search_list(**params):
    if not reserve_search_calls(1):
        return None
    # 이 글에는 별도 구현인 call_youtube_search_list가 필요하다.
    return await call_youtube_search_list(**params)

async def collect_tier0_and_keywords():
    # 이 예시는 비동기 애플리케이션 진입점에서 await해 호출한다.
    shorts = await budgeted_search_list(q="#shorts", type="video")
    for keyword in AI_KEYWORDS + IT_KEYWORDS:
        result = await budgeted_search_list(q=keyword, type="video")
        if result is None:
            break
        # 다음 페이지도 budgeted_search_list(...)로 별도 호출한다.
    return shorts
위 예시는 단일 수집 프로세스를 위한 간단한 지속 카운터입니다. Tier 0 쇼츠 검색, 글로벌 키워드 검색, 추가 페이지 요청을 포함해 모든 search.list 호출이 budgeted_search_list()를 통과해야 합니다. 기본 100회 중 10회를 남겨 자동 호출은 최대 90회에서 멈추게 합니다. 여러 worker가 동시에 실행된다면 파일 대신 PostgreSQL 같은 공유 저장소에서 트랜잭션으로 일일 호출 수를 원자적으로 예약해야 합니다.
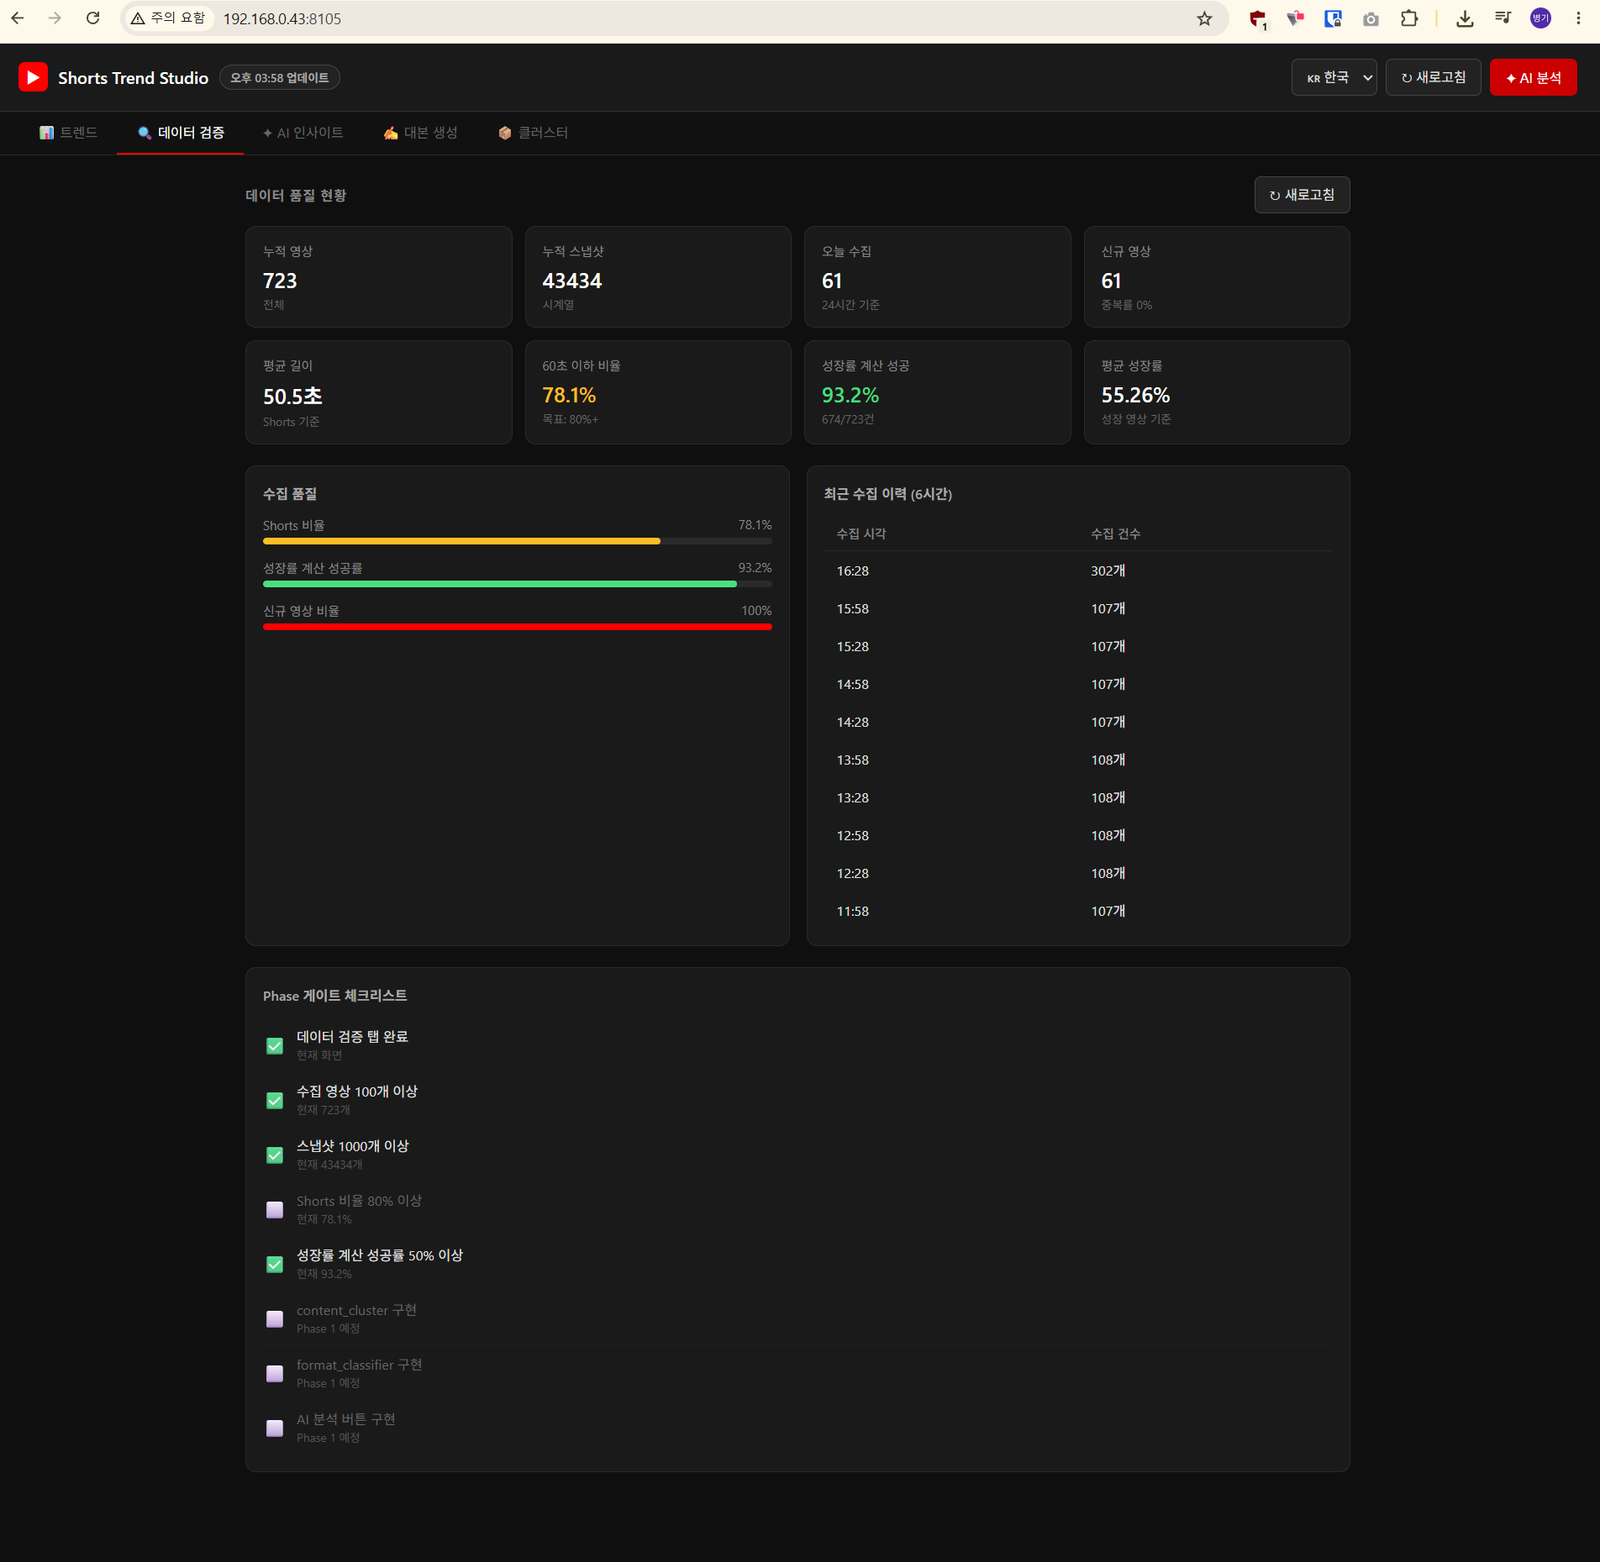
글로벌 수집 추가 후 안정적으로 운영 중인 수집 현황
실제 운영 결과
이 사례에서는 UGREEN DXP4800PLUS NAS에서 수집 시스템을 30분 주기로 구성했습니다.
- 수집 영상: 약 700개
- 저장 스냅샷: 4만 개 이상
- API 사용량(2026년 6월 이전 운영 기록): 하루 약 4,000~5,000유닛
- 사용률(2026년 6월 이전 운영 기록): 할당량의 약 40~50%
- 수집 주기: 30분
초기에는 쿼터 부족 오류가 반복적으로 발생했지만, search.list 사용 빈도를 줄이고 수집 주기를 분리한 후에는 안정적으로 운영되고 있습니다.
현재 수집 구조 요약
30분마다 실행
↓
Tier 0: 한국 급상승 50개 (1유닛)
Tier 0: 쇼츠 검색 (동일 budgeted_search_list로 일일 예산 차감)
Tier 1: 글로벌 AI/IT 키워드 (Search Queries 남은 호출 수를 확인해 실행)
↓
기존 영상 100개 스냅샷 갱신 (2유닛)
↓
성장률 계산 → 클러스터 분류
이 운영 수치는 2026년 6월 이전 체계에서의 기록입니다. 현재는 Search Queries 버킷과 일반 quota 버킷을 분리해 확인합니다.
YouTube Data API 사용 시 핵심 정리
search.list사용 횟수를 Search Queries 일일 한도 안에서 관리한다videos.list+chart=mostPopular를 활용한다 (1유닛)- 배치 조회를 활용한다 (50개를 한 번에 = 1유닛)
- 수집 주기를 분리해 불필요한 호출을 줄인다