
YouTube Data API의 quota 구조는 2026년 6월부터 달라졌습니다. 현재 search.list는 Search Queries 전용 버킷에서 호출당 1단위·기본 100회/일로 관리됩니다. videos.list도 호출당 1단위이지만 다른 일반 엔드포인트와 함께 기본 10,000단위/일 버킷을 사용합니다.
따라서 지금의 핵심은 검색 호출에 별도 일일 한도가 있다는 점입니다. 아래 내용은 2026년 9월 16일 Google 공식 문서를 기준으로 다시 정리했습니다.
현재 search.list와 videos.list의 quota 구조
| API | 용도 | 현재 quota 구조 |
|---|---|---|
search.list |
키워드로 영상·채널·재생목록 검색 | Search Queries 버킷, 호출당 1단위, 기본 100회/일 |
videos.list |
알고 있는 영상 ID의 상세 정보 조회 | 일반 버킷, 호출당 1단위 |
| 기타 일반 엔드포인트 | 채널·재생목록 등 조회 | 일반 버킷 합산 기본 10,000단위/일 |
Google의 search.list 공식 문서는 현재 호출당 1단위와 기본 100회/일 Search Queries 제한을 안내합니다. videos.list 공식 문서는 호출당 1단위로 안내하고, Quota Calculator는 search.list·videos.insert를 별도 버킷으로, 나머지 엔드포인트를 일반 10,000단위/일 버킷으로 설명합니다. 2026년 6월 1일 granular quota 전환 내용은 YouTube Data API 변경 이력에서 확인할 수 있습니다.
왜 search.list 호출 수를 따로 관리해야 하나
search.list는 현재 호출당 비용 자체는 1단위지만 기본 일일 호출 한도가 100회입니다. 예를 들어 키워드 4개를 30분마다 하루 48번 검색하면 계산상 192회의 search.list 호출이 필요해 기본 100회/일 한도를 넘습니다.
키워드 4개 × 하루 48회 실행 = search.list 192회/일
기본 Search Queries 한도 = 100회/일
반면 이미 확보한 영상 ID의 조회수·좋아요·길이 등을 갱신할 때는 videos.list를 사용하면 됩니다. 이 호출은 일반 quota 버킷을 사용하므로 신규 검색과 기존 영상 갱신을 분리하는 편이 운영상 유리합니다.
반복 검색을 줄이는 패턴
이미 수집한 영상을 갱신할 때까지 매번 같은 키워드를 다시 검색하면 Search Queries 버킷을 빠르게 소모합니다.
# 비효율적인 예시: 30분마다 같은 키워드를 전부 다시 검색
keywords = ["ChatGPT", "Claude AI", "n8n", "NAS"]

for keyword in keywords:
    results = youtube.search().list(
        q=keyword,
        type="video",
        part="id",
        maxResults=50,
    ).execute()
검색 결과를 한 번 확보했다면 영상 ID를 저장하고, 기존 영상 갱신은 videos.list로 분리합니다.
video_ids = load_known_video_ids()

for i in range(0, len(video_ids), 50):
    batch = video_ids[i:i+50]
    details = youtube.videos().list(
        id=",".join(batch),
        part="snippet,statistics,contentDetails",
    ).execute()
신규 검색과 기존 영상 갱신 분리
제가 운영하던 쇼츠 수집기에서도 30분 주기로 모든 키워드를 반복 검색하던 구조가 병목이었습니다. 현재 quota 체계에서는 검색 호출 횟수 자체를 줄이는 것이 중요하므로, 신규 검색과 기존 영상 갱신 시간을 분리할 수 있습니다.
from datetime import datetime

# 예시: 매시 전반부에는 신규 검색, 후반부에는 기존 영상 갱신
run_search = datetime.now().minute < 30

if run_search:
    new_videos = await collect_global_keywords(AI_KEYWORDS)
else:
    await refresh_existing_snapshots()
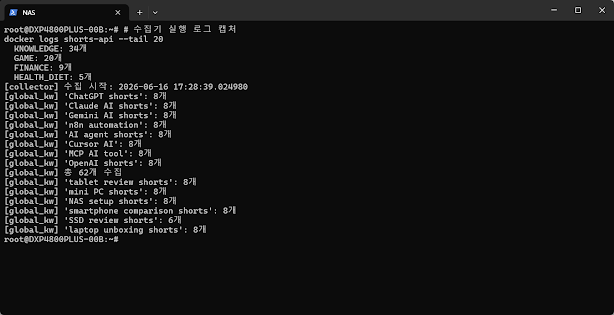
이 글은 Google 공식 문서의 2026년 9월 16일 quota 구조와 기존 수집기의 호출 패턴을 기준으로 설명합니다. 실제 프로젝트에 배정된 quota와 증액 승인 상태는 Google Cloud Console에서 확인하세요.
언제 search.list를 쓰고 언제 videos.list를 쓸까
search.list가 필요한 경우
- 키워드로 새로운 영상을 찾을 때
- 특정 조건으로 새로운 채널·재생목록을 탐색할 때
- 아직 ID를 모르는 리소스를 검색할 때
videos.list가 적합한 경우
- 이미 알고 있는 영상 ID의 상세 정보 조회
- 기존 수집 영상의 조회수·좋아요 갱신
- 여러 영상 ID를 묶어 상태를 다시 읽을 때
핵심은 다음처럼 나눌 수 있습니다.
신규 발견 → search.list
기존 영상 갱신 → videos.list
마무리
2026년 9월 현재 search.list와 videos.list는 모두 호출당 1단위지만 서로 다른 quota 구조를 사용합니다. search.list는 전용 Search Queries 버킷의 기본 100회/일 제한을 먼저 보게 되고, videos.list는 다른 일반 엔드포인트와 함께 기본 10,000단위/일 버킷을 사용합니다.
따라서 자동 수집기를 설계할 때는 과거의 “100배 비용” 공식을 그대로 적용하지 말고, 검색 호출 횟수와 일반 조회 호출량을 각각 따로 관리해야 합니다.