AI 에이전트가 필요한 작업과 단순 자동화로 충분한 작업 구분하기
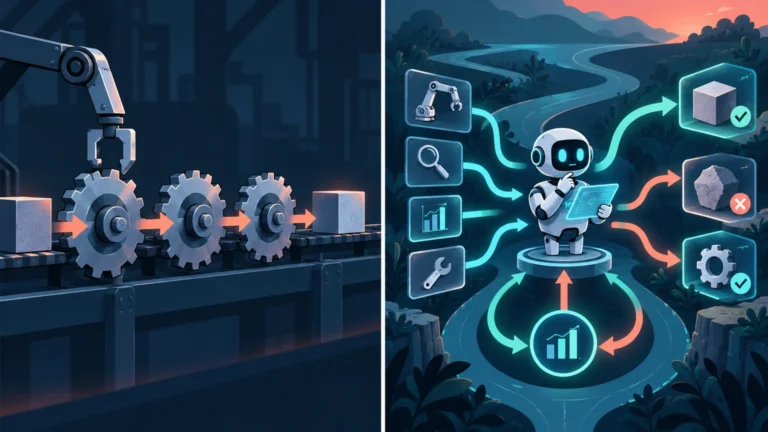
AI 에이전트가 필요한 작업과 단순 자동화로 충분한 작업을 결정론성, 자율성, 복잡도, 도구 호출, 상태 관리, 사람 승인 기준으로 쉽게 구분하는 방법을 설명합니다. AI 에이전트가 모든 자동화 작업을 대신할 필요는 없습니다.

AI 에이전트가 필요한 작업과 단순 자동화로 충분한 작업을 결정론성, 자율성, 복잡도, 도구 호출, 상태 관리, 사람 승인 기준으로 쉽게 구분하는 방법을 설명합니다. AI 에이전트가 모든 자동화 작업을 대신할 필요는 없습니다.
AI 데이터 분석 결과의 오류를 검증하는 방법을 정리했습니다. 이상치 영향도, 원천데이터 품질, 상관계수와 유의성 검정, 교란변수 통제, 인과관계 검증 설계를 쉽게 확인해 보세요. 먼저 행 개수, 열 이름, 자료형, 결측치, 중복 행을 원천 파일과 대조합니다.
MCP Tools·Resources·Prompts가 각각 무엇을 담당하는지 설명하고, tools/list·resources/read·prompts/get 같은 JSON-RPC 메서드를 REST API 엔드포인트와 비교합니다.
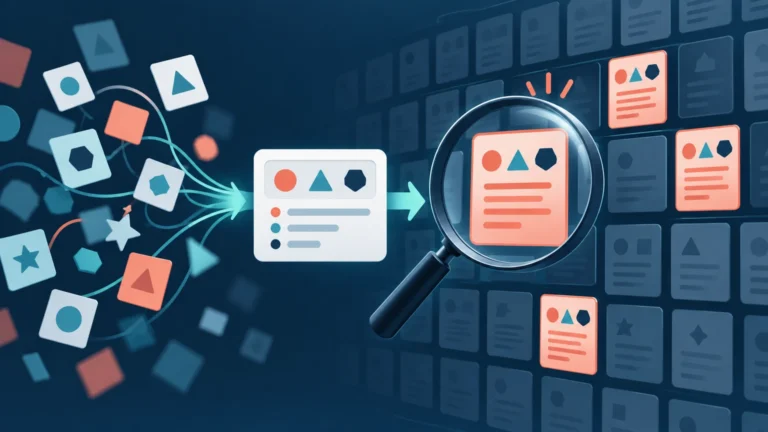
RAG 검색 쿼리 재작성으로 검색 정확도를 높이는 방법을 설명합니다. 검색 의도 분석, 대화 문맥 해소, 재작성 프롬프트 설계, 원문 비교와 검색 결과 평가 절차를 예시와 함께 정리했습니다.
파인튜닝, RAG, 프롬프트 엔지니어링의 차이를 비용·운영 부담·최신 정보 반영 기준으로 비교하고, 실무 문제별 선택법과 조합 방법을 코드 예시와 함께 설명합니다. 이 글은 AI 언어 모델 API를 활용하는 실무자를 전제로 합니다.
MCP 서버 설계 방법을 Tools·Resources·Prompts의 역할부터 입력 스키마, 오류 처리, 호출 흐름, 권한 제한과 자동화 연결 시 주의점까지 쉽게 정리합니다. 무엇이든 Tool로 만들면 호출 대상이 늘어납니다.
한국어 TTS 품질을 높이는 핵심 요소를 정리합니다. 숫자·영문·고유명사 전처리, 문장 분할, 속도·쉼·억양 조정과 엔진 선택 기준을 살펴봅니다. 숫자, 영문, 약어, 고유명사, 괄호와 특수문자는 그대로 입력하면 읽는 방식이 어색해지기 쉽습니다.
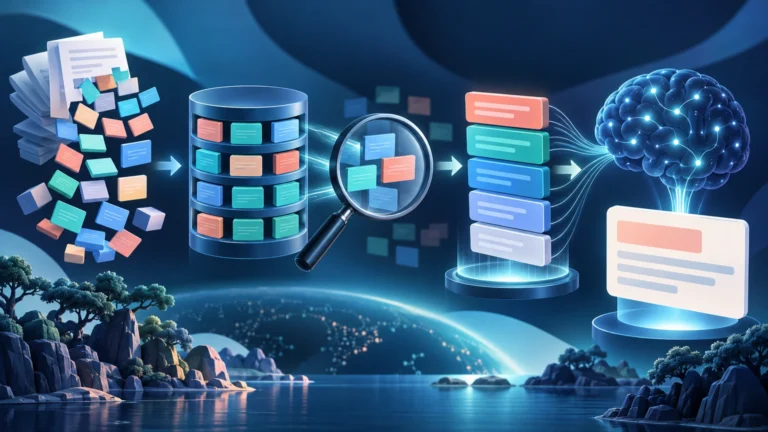
RAG 파이프라인 설계 방법을 단계별로 정리합니다. 문서 청킹 전략부터 임베딩 모델 선택, 벡터 유사도 검색, 메타데이터 필터링, 리랭킹 구성과 점검 방법까지 쉽게 설명합니다. 문서 청킹은 원문을 검색 가능한 단위로 나누는 단계입니다.
벡터 검색 결과가 엉뚱하게 나오는 이유를 거리 함수와 정규화, 임베딩 모델 일관성, ANN 인덱스 정확도, 청크 크기와 오버랩, Top-k와 점수 임계값 관점에서 쉽게 설명합니다.
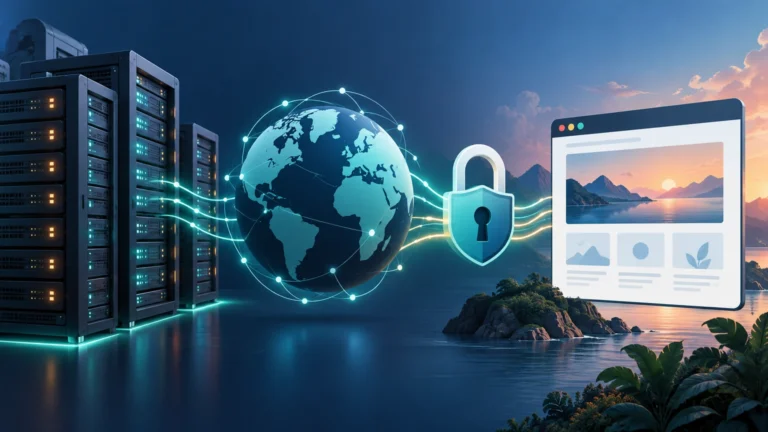
웹사이트 호스팅 방법을 처음부터 배우고 싶다면 정적·동적 사이트 차이, 공유 호스팅과 가상 서버 비교, 도메인 DNS 연결, 웹 서버 배포, HTTPS 인증서 적용 순서까지 한 번에 확인해 보세요.